别动不动就上 RAG,你的个人知识库关键词检索就够了
个人知识库用关键词检索往往就够。企业库再谈 RAG、混合检索和检索前的权限。
也在公众号发布
前几天我给同事看我的工作看板。页面有一块小区域,可以调大模型直接问答。同事扫了一眼,随口问我:你这底层接的是不是 RAG?
我说还真不是。这只是个个人知识库,底层跑的是最普通的关键词检索和内容检索,拼进上下文就完事了。
这一问让我想到,很多本地 Agent 也不是严格意义上的 RAG 形态。连了本地文档就以为应该是 RAG,这想法挺普遍的,但个人库和企业库根本不是一回事。
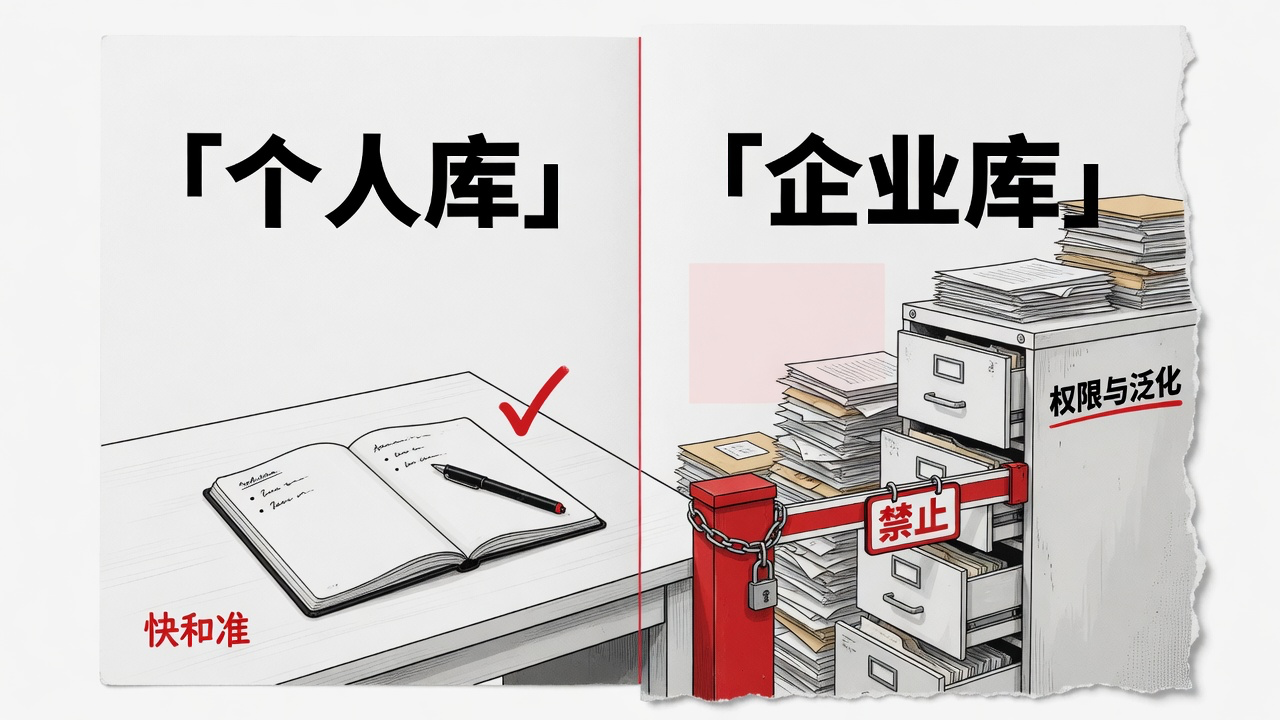
01 个人库和企业库,本质上是两码事
很多人做选型容易犯迷糊,是因为把自己的玩具和公司的系统混在一起聊。
个人库和企业库在底层逻辑上有很大区别。
第一是语料规模。
我自己的项目看板,里面就是日常文档和待办,体量不大。全部转成纯文本也塞不满内存,计算机吃这点数据跟玩一样。
企业库动不动就是上万份制度汇编、成千上万个代码仓库、几十个部门堆积了十年的 Confluence 页面。这种规模如果不做分块、索引和召回分层,大模型的上下文窗口根本塞不下,费用也吃不消。
第二是权属和边界。
我自己的电脑,数据全是我自己的。我看什么、查什么,完全不需要授权,不需要考虑张三能不能看李四的绩效,也不用防着实习生搜到高管薪酬。
企业环境里,数据权属极其复杂。销售只能看自己片区的合同,财务有一套单独的隔离网络,研发连核心代码权限都要走审批流。
第三是问法习惯。
我查自己的看板,问法通常极度具体。我会直接搜:上周二提到的那个集成接口报错码是多少?或者搜:xx客户提的那个超时工单解决了没?
这些词汇都是我自己写进去的,我清楚自己当初用了哪个专有名词,哪个代号。
但在企业通用库里,提问的人往往并不知道标准答案在哪个文档里,甚至不知道标准术语是什么。一个新员工可能会问:请假流程怎么走?而制度文件上写的其实是员工考勤与休假管理办法实施细则。这种时候语义泛化才真正体现出价值。
第四是审计和出处要求。
我自己用看板,AI 回答一个结论,我扫一眼心里就有数,知道它对不对,大不了自己点开文件瞅一眼。
企业场景不行。AI 必须明确给出引文出处:来自第几号文件、第几章第几条、由谁在什么时间更新。如果没有追溯机制,回答一旦出错,造成的业务损失根本没法定责。
02 什么时候关键词检索就足够好用
很多人看不起传统的关键词匹配和全文检索,觉得那是老古董。
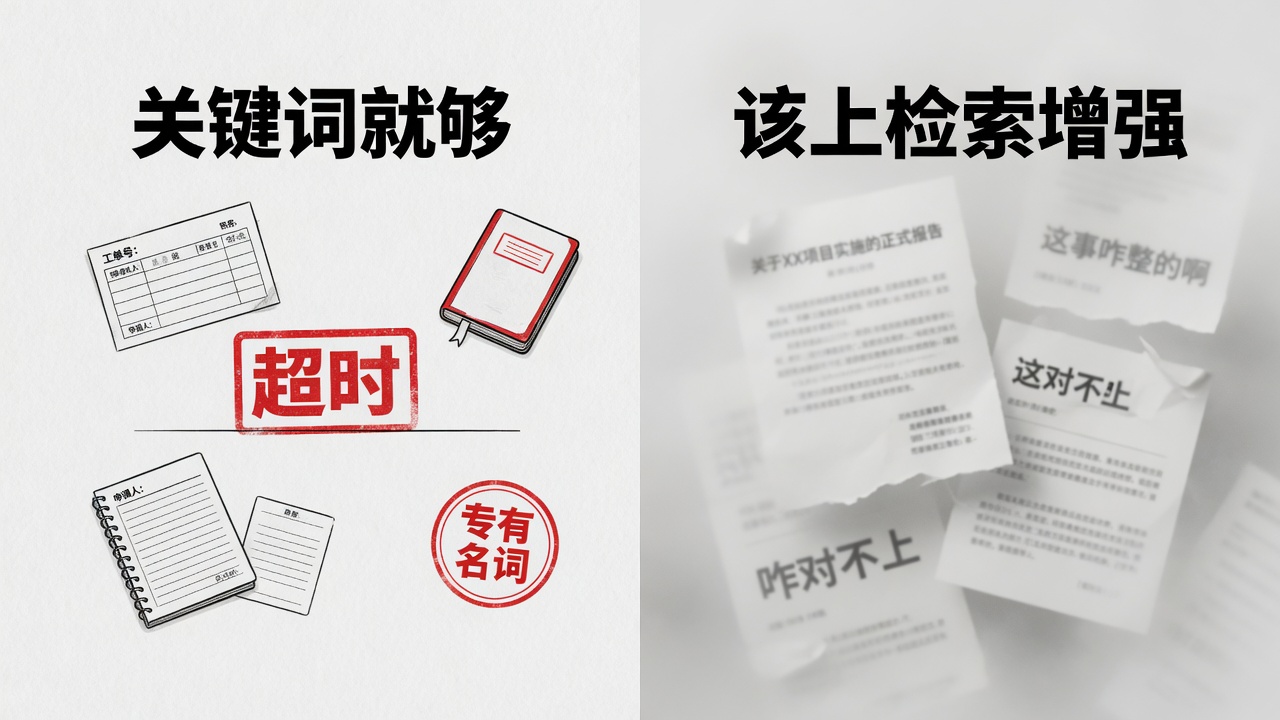
但在很多垂直场景下,纯向量检索的表现常常会被关键词检索按在地上打。
最典型的就是精确信息。
比如错误码 ERR_HTTP_504_TIMEOUT,或者一个订单流水号 2026090900182,再比如一个函数名 processUserRefundData。
如果你把这些东西扔进向量模型,向量模型会试图去理解它的语义空间,把它映射成一串浮点数。结果一检索,经常会漏掉最该匹配的那一行,反而给你召回一堆语义看起来相似、但根本不对头的日志或者解释段落。
关键词检索在这个领域是绝对的王者。它不跟你讲什么微积分,只要文本里出现了这个词,它就能毫秒级捞出来。
在项目管理、本地运维、个人笔记这些场景里,充斥着大量的项目缩写、人名、缩略语和排期标记。这些文本语义密度极低,符号特征极强。
如果你的知识库只有几百个文件,或者你平时查的东西大部分都是专有名词,那就老老实实用 SQLite 的全文索引,或者用最原始的文本匹配。速度快,零额外资源消耗,不用跑向量模型,准确率还出奇地高。
不仅部署起来零负担,排错也极其简单。查不到就是没命中词,改改词或者加个同义词表就行,不用对着一堆向量余弦相似度猜谜。
内部库里,关键词并不一定输给纯向量。
03 什么时候必须认真考虑 RAG
当然我也不是否定 RAG。当系统的边界扩大到一定程度,简单的全文搜索确实会撞墙。
首先是跨概念检索。
用户如果不知道专有名词,只能用大白话提问,比如问:电脑蓝屏了去哪里领新的?
如果库里的文档写的是固定资产损毁调换申报审批流,传统的关键词搜索大概率会交白卷。这时候需要向量把用户的意图和文档里的业务流程连接起来。
其次是语料库极其分散且庞大。
当你的文档达到几万甚至几十万页,你不可能把整篇整篇的内容塞给大模型。你需要先把它们切成均匀的碎片,给每个碎片提取特征,建立向量索引。
用户提问时,系统从几十万个碎片里挑出最相关的三五段,组合成一段背景材料,交给大模型去归纳润色。这是 RAG 核心解决的场景。
还有一种情况是多语言混合。
公司里有英文 API 手册,也有中文用户手册。用户用中文问接口报错怎么办,系统需要穿透语言壁垒,从英文技术文档里把那段逻辑找出来。纯关键词很难直接跨语言对齐,向量检索在这里就省心得多。
简单来说,当你的主要矛盾从找不到具体代号,变成了看不懂用户在问啥,或者文档体量大到塞不下的时候,再上 RAG 也不迟。
04 企业落地时几个容易踩的坑
到了企业生产环境落地检索增强,有两个关键设计原则值得提前看清。
第一个原则是,生产环境里几乎见不到纯向量方案,常见的是混合检索。
纯向量检索擅长找大概意思,容易丢关键专有名词;关键词检索擅长扣死字眼,但是缺乏灵活性。
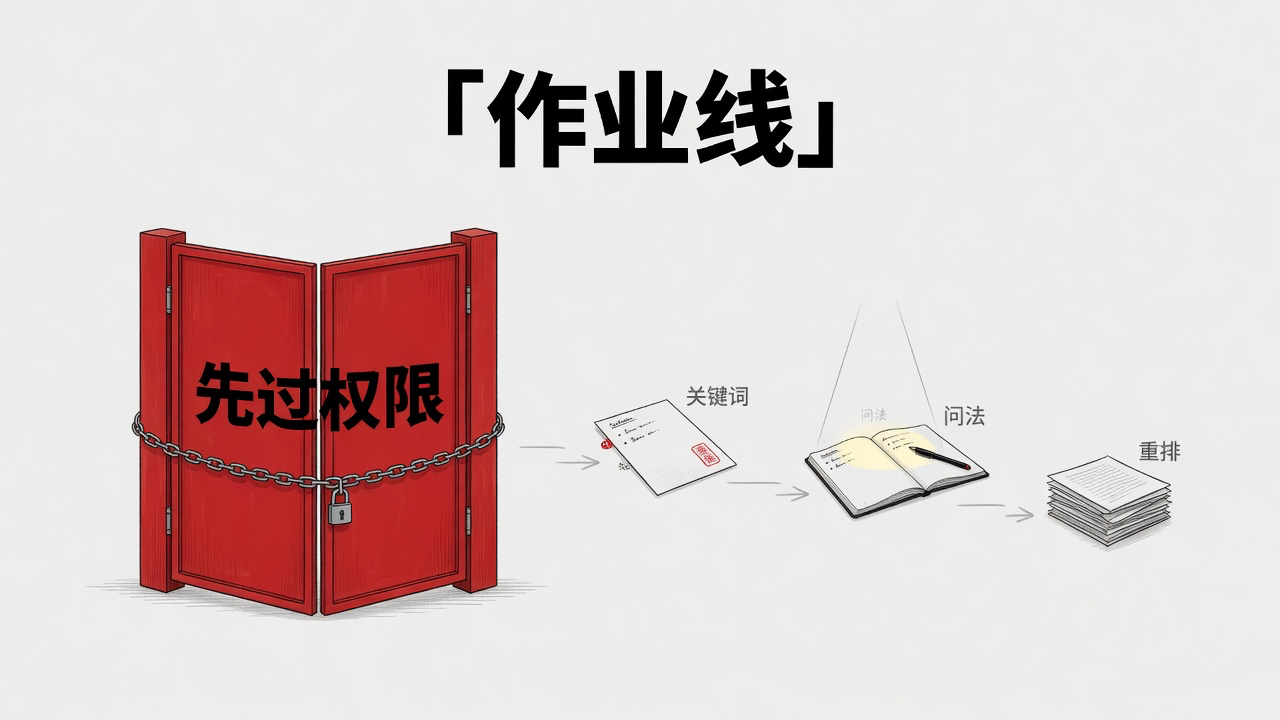
把这两者结合起来,先用关键词打底兜住 ID、人名、错误码,同时用向量拉取意图相关的上下段落,最后做重排。生产环境里常见这种 hybrid:关键词或 BM25 兜精确词,向量补意图。
第二个原则跟安全合规死磕到底:权限过滤必须放在检索发生之前。
不少人设计系统时偷懒,让大模型或者检索器在全库里搜一圈,找出前十条最相关的结果,然后再去判断当前用户有没有查看这十条结果的权限。如果有三条没权限,就把它剔除掉。
这种做法隐患极大。一方面它会导致有效召回不足,本来能看到的文档被挤出去了;另一方面,甚至可能在元数据或者大模型推理残留里发生越权信息泄露。
业内标准的做法是预先过滤。在向量匹配或者关键词扫描的那一刻,检索条件里就已经带上了用户身份对应的访问控制列表。
你只能在你能看到的数据范围里做相关性计算,根本没有资格去触碰其他密级的内容。把权限卡在检索前,系统才谈得上企业级安全。
05 一张决策清单
到底选全文检索,还是折腾一套完整的 RAG 流程?做决定前可以照着下面几条对一对:
- 文档体量在百兆以内,个人或极小团队使用:优先用轻量全文检索,配合大模型长文本窗口直接灌入,性价比最高。
- 检索内容以代码、工单编号、专有名词、API 接口为主:以关键词或倒排索引为主,向量只作辅助。
- 业务属于海量文档咨询,问法千奇百怪,用户不知道官方命名:必须使用语义检索,上标准 RAG。
- 涉及多语言对齐,或者需要从长篇大论中抽取极其零碎的知识点:上 RAG,重点打磨切分策略和重排模块。
- 涉及企业内部多部门敏感权限:无论怎么做检索,先把检索前的权限过滤网焊死。
工具是拿来干活的。拿来充门面,最后吃亏的是交付进度。
个人看板跑个关键词检索一点都不寒碜,不仅省电,反应还比一堆向量数据库转来转去快得多。清楚自己的语料和诉求到底是什么,比盲目堆架构管用得多。
张坤专注企业 AI Agent 落地的项目经理
我是张坤,专注企业 AI Agent 落地的项目经理。 这里沉淀 RAG、知识库、数据治理、Agent 项目从立项、落地交付到成本算账的一手实践,也坦诚记录项目失败与踩坑复盘。 少聊大模型纸面能力,聚焦 AI 在真实企业场景里如何落地、存活,真正产生业务价值。